Benchmark Validity for Multilingual and Code-Switching Models
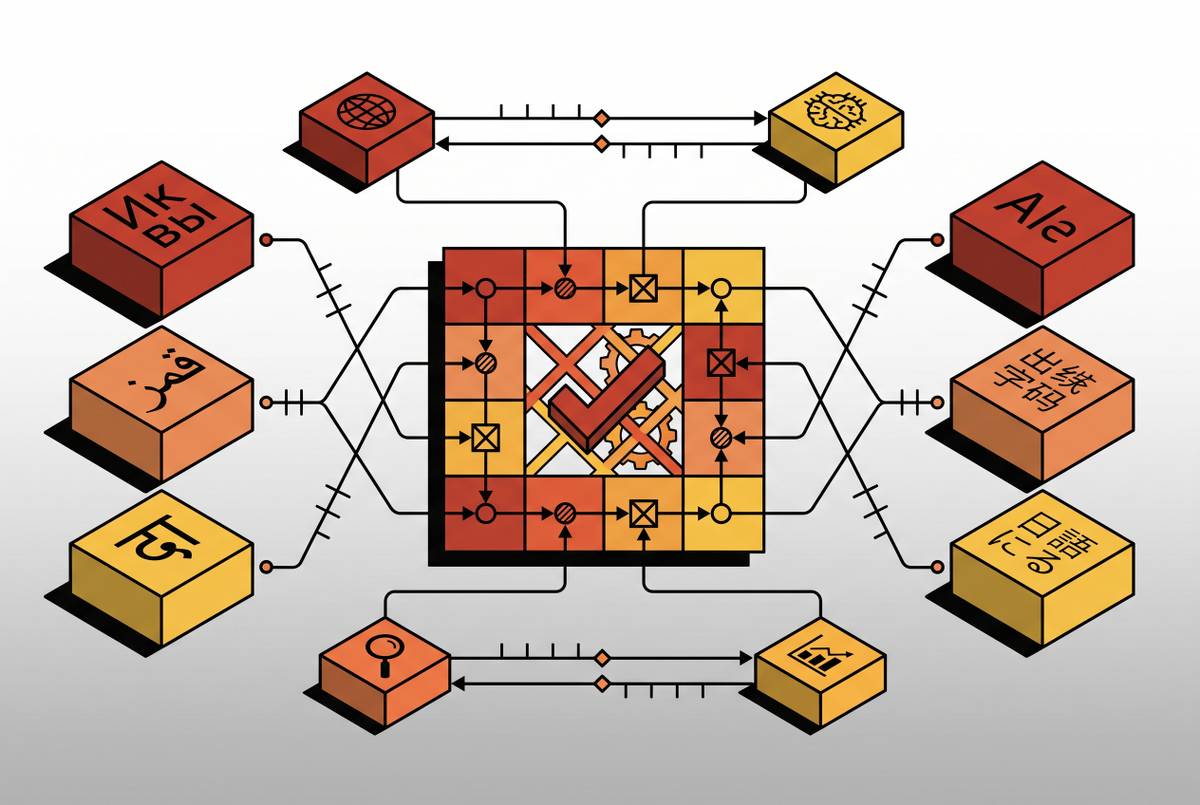
Current benchmarks mismeasure multilingual AI ability.
Casimir Wojcik
Section
8 stories in Golden Datasets.
Current benchmarks mismeasure multilingual AI ability.
Synthetic test data helps teams catch AI failures before production reaches real users.
Accuracy masks which failure modes your eval set actually covers.
Eval datasets drift silently from production; version control and lineage tracking catch it.
Models drift silently in production when training and real-world data diverge.
Unreliable human labels corrupt eval sets and mislead model rankings.
Models exploit benchmark quirks rather than develop real reasoning skills.
Stratified sampling reveals regressions in rare subgroups that average pass rates bury.